


Blog o datech, umělé inteligenci a mých projektech
Automatické shrnutí je vzít dlouhý text nebo dokonce sadu textů a automaticky generovat mnohem kratší text, který obsahuje většinu informací. Jednoduchý ? Ne tak moc. Nejprve musíte souhlasit, jaké informace jsou opravdu důležité. Pak je musíme být schopni je správně extrahovat, reorganizovat je, vše v gramatickém textu a bez zásahu člověka. A to je bez počítání s velkým počtem variant možných shrnutí !
Automatické shrnutí textu
S explozí sběru a skladování textury je potřeba analyzovat a extrahovat relevantní informace z této hmoty stále více a více přítomné.
Kromě toho, rozmach v modelech hlubokého učení pro automatické zpracování přirozeného jazyka (TALN) usnadnil použití textových dat v provozních otázkách. Shrnutí automatického textu, stejným způsobem jako otázka zodpovězení, analýza podobnosti, klasifikace dokumentu a další úkoly spojené s talnu jsou součástí těchto problémů.
Právě v této souvislosti Laboratorní inovace De Lincoln se rozhodl vykonávat práci na automatickém shrnutí textu. Tato díla umožnila vytvořit měřítko automatických souhrnných modelů k dispozici pro jazyk francouzština, Způsobit náš vlastní model a konečně jej uvést do výroby.
�� Školení modelu
Data
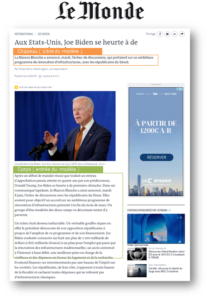
Než jsme mohli začít s prací, nejprve jsme museli vytvořit databázi pro výuku automatických souhrnných modelů. Získali jsme tiskové položky z několika francouzských zpravodajských webů. Tato základna obsahuje ~ 60k články a je neustále aktualizována.
Nejmodernější
Automatické souhrnné algoritmy lze rozdělit do dvou kategorií: shrnutí extrakční a shrnutí abstraktní. V rámci extrakční, Shrnutí jsou vytvořeny ze vět extrahovaných z textu, zatímco souhrny abstraktní jsou generovány z nových vět.
Automatické souhrnné modely jsou v angličtině docela běžné, ale jsou mnohem méně ve francouzštině.
Metriky
Pro hodnocení modelů jsme použili následující metriky:
ČERVENÉ : Nepochybně měření nejčastěji uváděné v souhrnných úkolech, vzpomínané podvědomí pro hodnocení Gisting (Lin, 2004) vypočítá počet podobných n-gramů mezi vyhodnoceným shrnutím a shrnutím lidského odkazu.
Meteor: Metrika pro vyhodnocení překladu s explicitním uspořádáním (Banerjee a Lavie, 2005) byl navržen pro hodnocení výsledků automatického překladu. Je založen na harmonickém průměru přesnosti a stažení na unigramech, přičemž vzpomínka má váhu větší než přesnost. Meteor se často používá v automatických souhrnných publikacích (viz et al., 2017; Dong et al., 2019), kromě červené.
Novinka: Bylo zaznamenáno, že některé abstraktní modely příliš spočívají na extrakci (viz et al., 2017; Krysci ‘nski et al.‘, 2018). Proto se stalo běžným měřit procento nových N-gramů vyráběných ve generovaných souhrnech.
Zdroj: Překlad z papíru MLSUM [2].
Nasazení modelů
Pro modelovou školení jsme použili službu Cloud Azure ML, která poskytuje kompletní prostředí pro školení, monitorování a nasazení modelů.
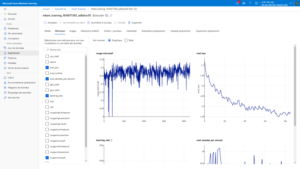
Přesněji jsme použili Python SDK, což vám umožní spravovat celé prostředí AzureMl programovým způsobem, od spuštění „úloh“ po nasazení modelů.
Náš konečný model jsme však zapouzdřili v aplikaci kontejnerované baňky a poté nasazeni přes potrubí CI/CD na klastru Kubernetes
Výsledky
Nejprve jsme provedli několik pokusů, což vedlo modely na 10k článcích, které mění počet žetonů uvedených na začátku modelu (512 nebo 1024) a různých architektur.
První pozorování: Metriky červených a meteorů se nezdají být velmi vhodné pro posouzení výkonu našich modelů. Proto jsme se rozhodli založit naše srovnání pouze na skóre novinky a vybráni architektura upřednostňování abstraktivnějších shrnutí.
Po stisknutí tréninku našeho modelu na 700k položky jsme výrazně vylepšili výsledky a ověřovali první verzi, kterou najdete níže.
Body pozornosti
Kromě představení nám tento experiment umožnil některé zdůraznit Hranice Automatické shrnutí:
V současné době je velikost textu ve vstupu typových modelů Přeměnit je omezena kapacitou na památku GPU. Náklady na paměť jsou kvadratické s velikostí textu jako vstupu, což představuje skutečný problém pro úkoly automatického shrnutí, kde je text, který má být shrnut, často dostatečně dlouhý.
Je velmi obtížné najít relevantní metriky pro posouzení úkolů generování textu.
Buď opatrný hmotnost extraktoru : Také jsme se setkali s několika problémy souvisejícími s údaji samy o sobě. Hlavním problémem je, že článek článku byl často parafrází nebo dokonce duplikátem prvních vět článku. To mělo důsledek povzbuzení našich modelů, aby byly extraktivnější než abstraktivní tím, že jednoduše vrátí první věty článku. Proto bylo nutné provést kurativní práci smazáním problému s předpisy, aby se zabránilo tomuto zaujatosti.
Blog o datech, umělé inteligenci a mých projektech.
Automatické shrnutí je vzít dlouhý text nebo dokonce sadu textů a automaticky generovat mnohem kratší text, který obsahuje většinu informací. Jednoduchý ? Ne tak moc. Nejprve musíte souhlasit, jaké informace jsou opravdu důležité. Pak je musíme být schopni je správně extrahovat, reorganizovat je, vše v gramatickém textu a bez zásahu člověka. A to je bez počítání s velkým počtem variant možných shrnutí !
Tento příspěvek jsem byl schopen pracovat asi rok na tomto vzrušujícím tématu, tento příspěvek je pro mě příležitostí, abych se ponořil do tohoto tématu a zhodnotil nejnovější inovace v doméně.
Vezměme si tedy přehled o tomto tématu vytvořením popisem různých typů shrnutí, které existují, než na dva typy systémů mírně podrobněji: ty z AI a neuronových sítí a ty, které se spíše zaměřují na optimální extrakci informace.
Různé typy shrnutí
Když mluvíme o shrnutí, často přemýšlíme o zadní obálce knihy nebo popisu skriptu pro film. Obecně se vyhýbají zkažení konec, když to je přesně to, co by člověk požádal o nástroj klasického automatického shrnutí: vyprávět intriku, aby shrnutí mohlo stačit k známému základu nákladům. Tady je o Shrnutí mono-dokumentů, To znamená, že shrnujeme pouze jediný dokument (film, kniha, článek, …).
Naopak, mohli bychom chtít a Multidokumentní shrnutí, že se setkáváme častěji v kontextu tiskových recenzí: Chceme mít shrnutí nejdůležitějších informací, jak uvádějí různé tiskové organizace.
Jakmile jsme se rozhodli o typu dat, které se snažíme shrnout, mono nebo multidokumentary, máme na výběr mezi dvěma přístupy:extrakční, který spočívá v extrakci jako to z informací před jejich uvedením zpět k vytvoření shrnutí a přístupu generativní, který spočívá ve vytváření nových vět, které se původně neobjevují v dokumentech, aby měli shrnutí plynulejší a volnější shrnutí.
Kromě těchto kritérií existují různé styly shrnutí, ke kterým se zde nebudeme přiblížit: Aktualizace shrnutí, které spočívají v souhrnu informací, které se objevují v novém dokumentu a které nebyly dosud uvedeny, shrnuto, které se skládá z přijetí přesného úhlu daný uživatelem, ..
AI a neuronové sítě revolucionizují automatické shrnutí
Až do poloviny -2010 bylo většina shrnutí extrakční. V těchto algoritmech však již existovala velká rozmanitost, která by se mohla pohybovat od výběru a extrakce celých vět po extrakci přesných informací, které se vyprávějí v textech s otvory připravenými předem nazývanými šablony. Příchod nových přístupů založených na neuronových sítích situaci výrazně změnil. Tyto algoritmy jsou mnohem efektivnější než ty předchozí pro generování gramatického a tekutého textu, jako to, co lze udělat s tímto demo GPT.
Neuronové sítě však vyžadují školení velkého množství dat a jsou relativně ukryté. Pracují dokonale, aby generovaly komentáře, pro které pravdivost má velmi důležité, ale silně mohou vytvářet protichůdné nebo jednoduše nesprávné informace, které jsou problematické například v souvislosti se souhrnem tiskových článků. Mnoho výzkumných článků má zájem o tyto „halucinace“ neuronových sítí.
Příklad hybridního nástroje: Potara
Automatické shrnutí bylo prvním výzkumným předmětem, o který jsem měl zájem, a měl jsem možnost vyvinout během svého pána hybridní systém shrnutí extrakcí/generováním pro vícedokumentový přístup, tj. Shrňte soubor dokumentů mluvících dokumentů stejného předmětu.
Záměrem bylo začít od klasické extrakce, konkrétně identifikovat nejdůležitější věty a sestavit je za účelem vytvoření shrnutí. Problém s tímto přístupem spočívá v tom, že nejdůležitější věty by se často mohly dále zlepšit. Například v článku, který mluví o prezidentském vysídlení, se věta „Emmanuel Macron setkala se svým americkým protějškem a diskutovala o ekonomice„ by mohla být vylepšena v „Emmanuel Macron Met Joe Bidena a diskutovat o ekonomice“. Novináři, kteří se pečlivě vyhýbají zkouškám, se často ocitneme s tímto druhem fenoménu.
K překonání této vady můžeme identifikovat podobné věty přítomné v různých dokumentech a pokusit se je sloučit, abychom získali lepší větu. ANSI, z následujících dvou vět:
- Emmanuel Macron se setkal se svým americkým protějškem ve Washingtonu a dlouho hovořil o ekonomice.
- Francouzský prezident se setkal s Joe Bidenem a diskutoval o ekonomice.
Můžeme vytvořit krátkou a informativní větu:
- Emmanuel Macron se setkal s Joe Bidenem ve Washingtonu a diskutoval o ekonomice.
K dosažení tohoto výsledku je nezbytné několik kroků: nalezení podobných vět, nalezení nejlepší fúze a kontrola, že fúze je mnohem lepší než původní věta. Zúčastní se mnoha technologií: Word2 s neuronovými sítí, aby našli podobné věty, grafy kosccurence, aby je sloučily, optimalizace ILP pro výběr nejlepších fúzí.
Pokud chcete vidět více, Potara je open-source, ale na chvíli nebyl udržován. Tento projekt byl výrazně sloužil jako vitrína, když jsem byl propuštěn, a proto jsem měl dokumentaci, testy, nepřetržitá integrace, nasazení na Pypi, ..
Co je to dobré automatické shrnutí ?
Pokud se některá kritéria zdají zřejmá a relativně jednoduchá (například gramatičnost vět), jiná jsou mnohem složitější. Rozhodování o tom, jaké nejdůležitější informace o textu jsou již samo o sobě velmi subjektivní úkol. Vyhodnoťte plynulost, správnou volbu použitých slov, vrací se k publikační práci a nemluvme o politické orientaci, kterou může shrnout shrnutí !
Nové generativní modely založené na neuronových sítích pravděpodobně představí pejorativní úsudky nebo kvalifikátory (nebo přátelsky uživatele), což je efekt požadovaný, pokud jde o generování filmového kritika, ale mnohem méně, když mluvíme o programu prezidentského kandidáta !
Automatické shrnutí proto zůstává velmi aktivním předmětem ve výzkumu a může být na okamžik, zejména s ohledem na schopnost vést výsledek algoritmu, přesně k určitému pocitu, konkrétnímu stylu, danému politickému zbarvení. V oboru právě začíná vstupovat velmi konkrétní vedoucí pracovníky (například shrnutí schůzek).
President 2022: K vašim údajům !
3 příklady datových projektů, které mají být provedeny pro prezidentské volby 2022.
